모아의 기웃기웃 · AI 이해하기 · 4편
배운 점에 더 잘 맞췄는데,
새 점에서는 왜 더 틀릴까요?
모델 복잡도를 바꾸며 훈련 오차와 검증 오차를 함께 비교해 보세요.
재생은 1~15차 모델을 차례로 비교합니다. 학습 시간이나 가중치 갱신 횟수를 뜻하지 않습니다.
훈련 오차
계수를 맞추는 데 사용한 18점
검증 오차
계수 학습에 쓰지 않은 36점
모델의 숫자 수
절편을 포함한 계수 d+1개
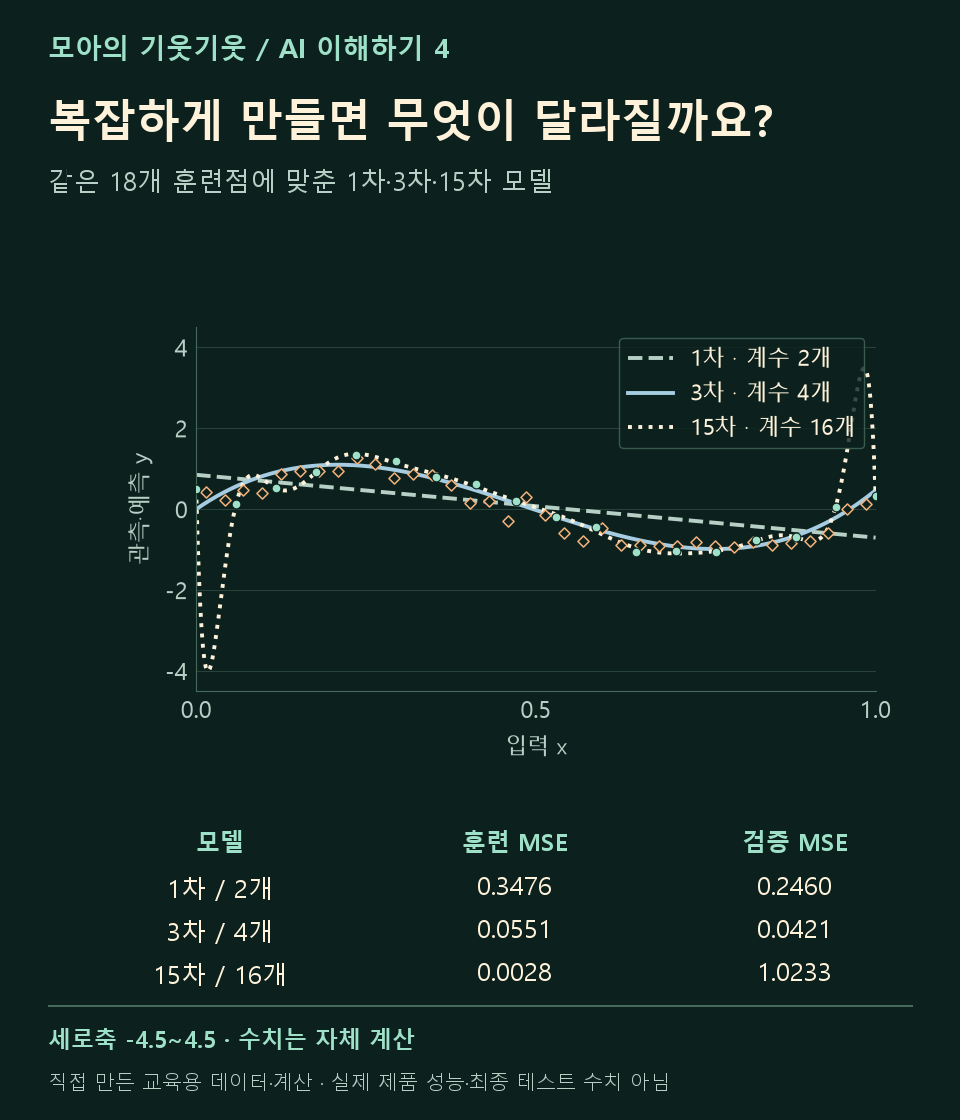
같은 모델을 두 데이터에 대입하면
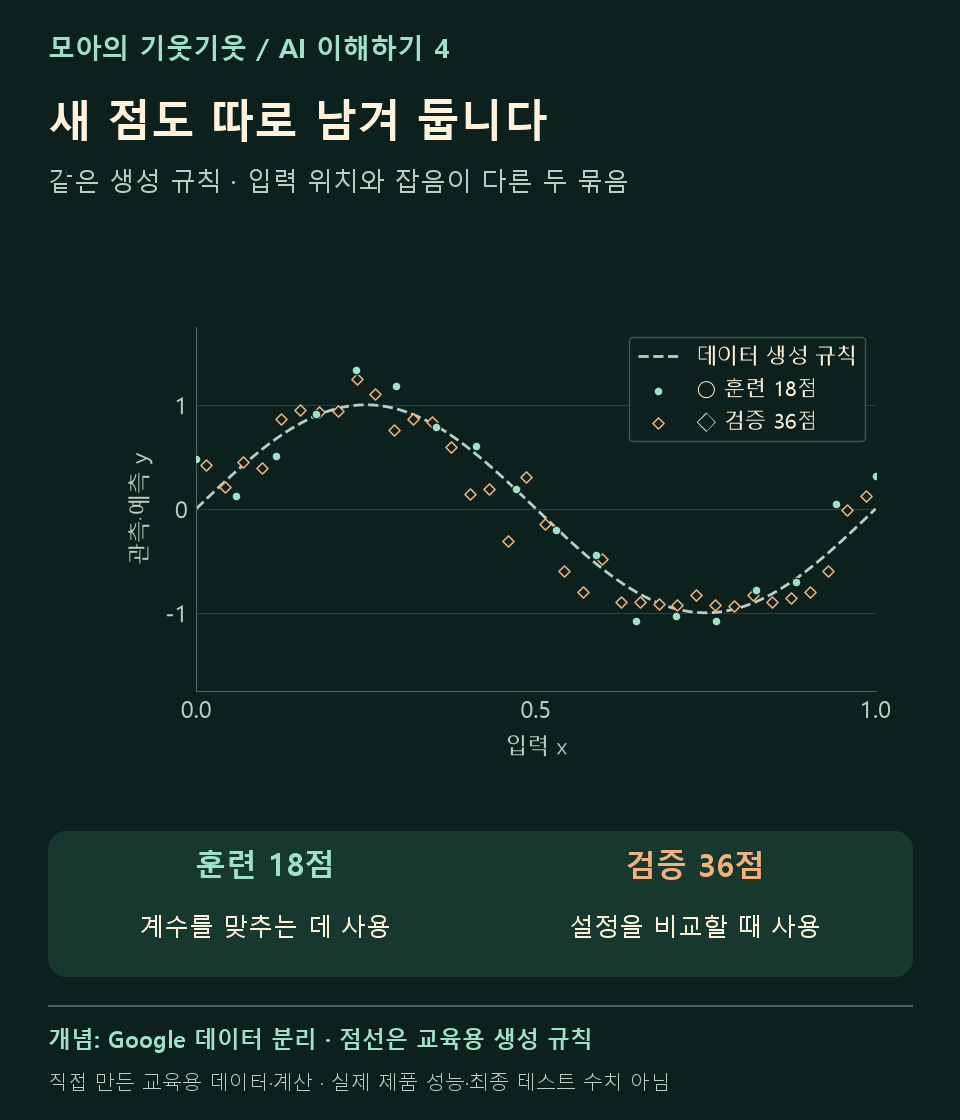
○ 훈련 18점◇ 검증 36점실선 · 현재 모델점선 · 데이터를 만든 곡선
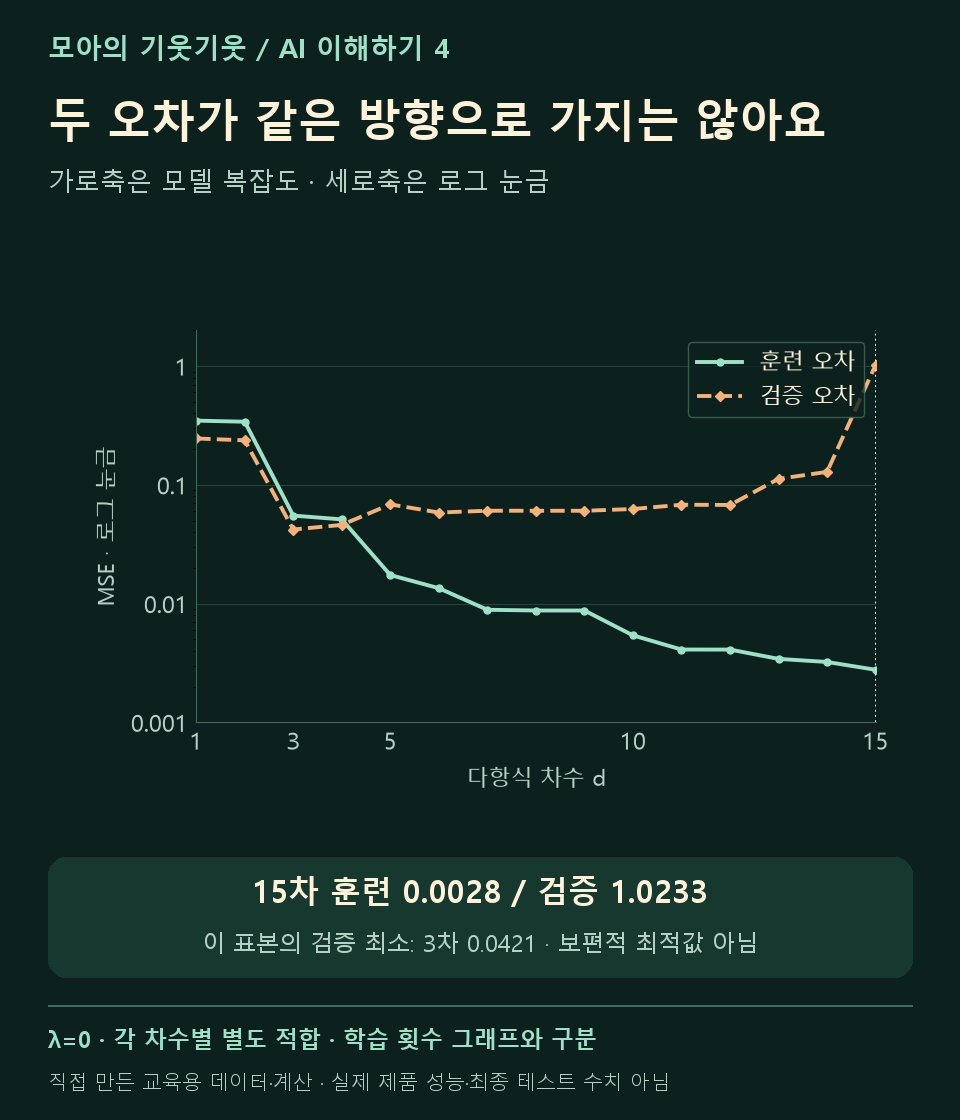
복잡도를 바꿀 때 두 오차
● 실선 · 훈련 MSE◆ 파선 · 검증 MSE세로선 · 선택한 차수
세로축은 로그 눈금입니다. 각 점은 별도로 계수를 맞춘 모델입니다.
점 표시를 꺼도 오차 계산은 유지됩니다. 기준 곡선은 교육용 데이터의 생성 규칙이며, 모델 학습에는 사용하지 않습니다.
| 차수 | 계수 수 | 훈련 오차 | 검증 오차 |
|---|
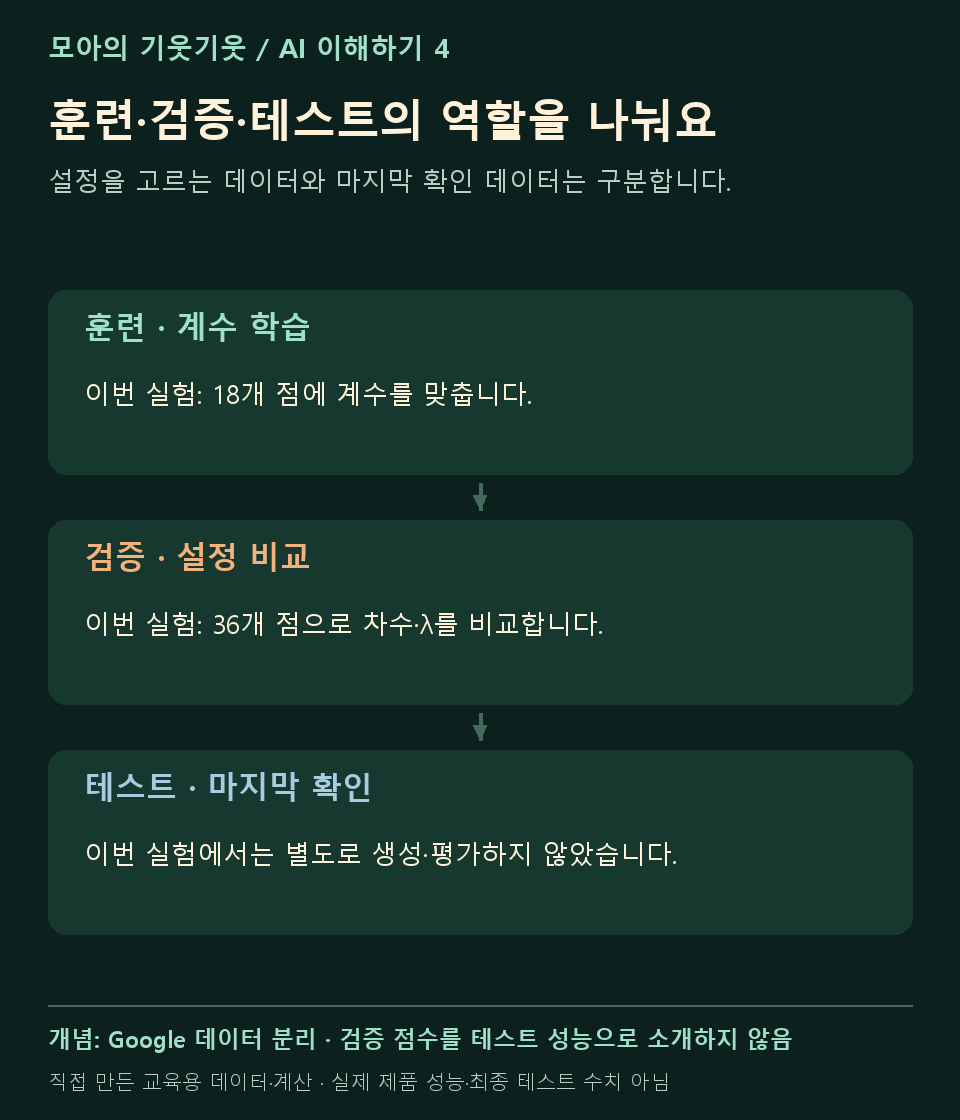
이 데이터에서 설정을 비교하는 실험입니다. 별도의 최종 테스트 점수는 계산하지 않습니다.
지난 XOR 실험에서 한 걸음 더
XOR의 네 점은 두 이진 입력의 전체 조합입니다. 지난편에서는 규칙을 표현하고 학습하는 능력을 봤습니다. 이번에는 새 표본을 만들 수 있는 곡선 문제에서 일반화를 확인합니다.
새 데이터가 중요한 이유
훈련 18점과 검증 36점은 같은 규칙에서 입력 위치와 잡음을 달리해 만들었습니다. 원에 더 가까워진 모델이 새로운 마름모에도 더 가까워지는지 확인해 보세요.
모델 복잡도와 학습 시간
1차·3차·15차는 각각 계수 2개·4개·16개인 다항식 모델입니다. 복잡도를 바꿔도 같은 데이터를 사용하며, 재생은 서로 다른 모델을 차례로 보여줍니다.
이번에 사용하는 L2 정규화
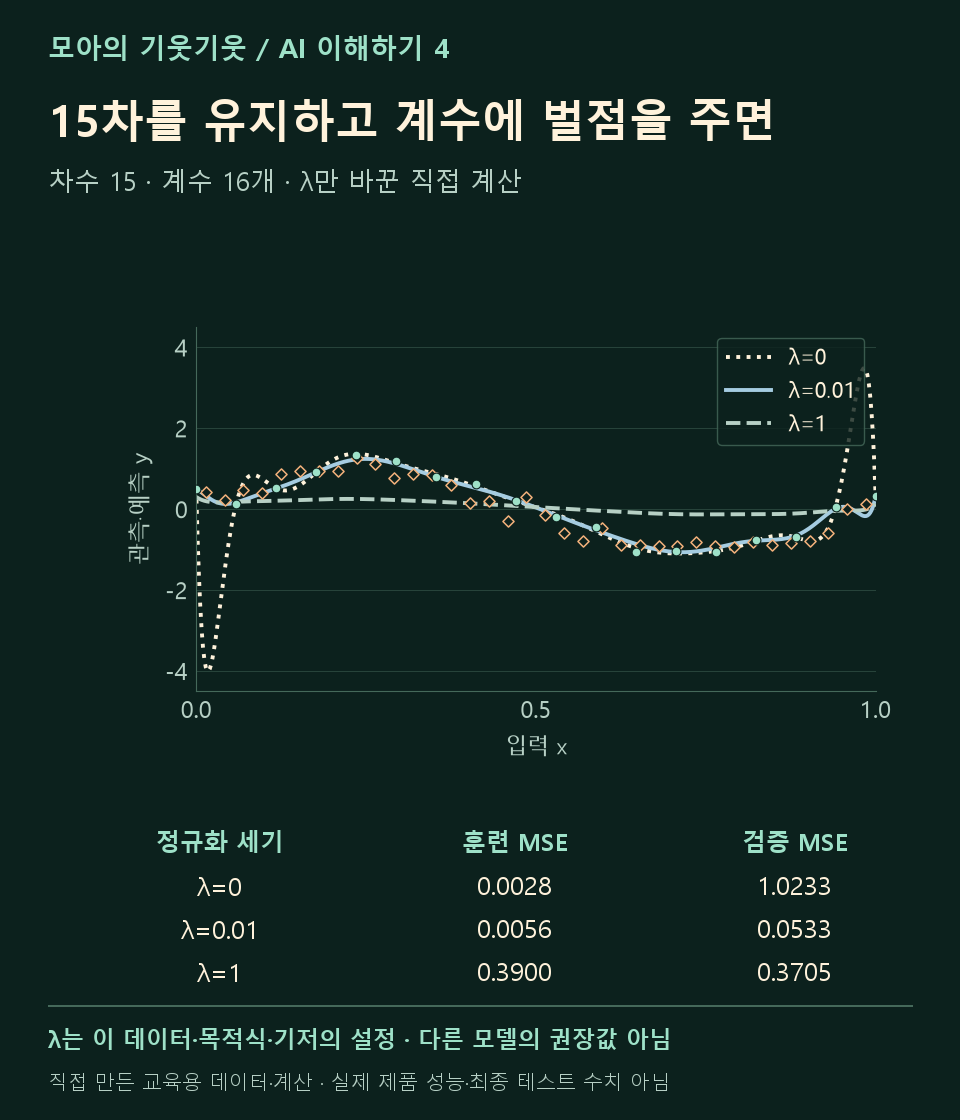
큰 계수를 사용하면 벌점을 더해 곡선의 표현을 제한합니다. λ는 그 세기이며, 계수 개수를 줄이는 조작은 아닙니다. 정규화에는 조기 종료 같은 다른 방법도 있지만 여기서는 L2 방식만 실험합니다.
L2 정규화 수식과 계산 조건 더 보기
기준 규칙은 sin(2πx), 정규 잡음의 표준편차는 0.18, 두 난수 시드는 2026·2027입니다. 입력 위치를 고정한 교육용 데이터로, 실측 데이터나 제품 성능 수치가 아닙니다.
목적식은 훈련 MSE + λΣⱼ≥₁βⱼ²입니다. 절편은 벌점에서 제외합니다. 차수 d의 Legendre 기저 Pⱼ(2x−1)의 계수에 벌점을 적용하며, 원래 x의 거듭제곱 계수에 주는 벌점과는 다를 수 있습니다. 표의 MSE에는 벌점을 더하지 않았습니다.
훈련 관측값으로만 QR 분해 최소제곱을 계산하고 별도의 NumPy 계산과 대조했습니다. 곡선은 세로축 고정이 기본이며 자동 조정으로 전환할 수 있습니다. 오차 그래프는 0.001~2의 로그 눈금입니다.
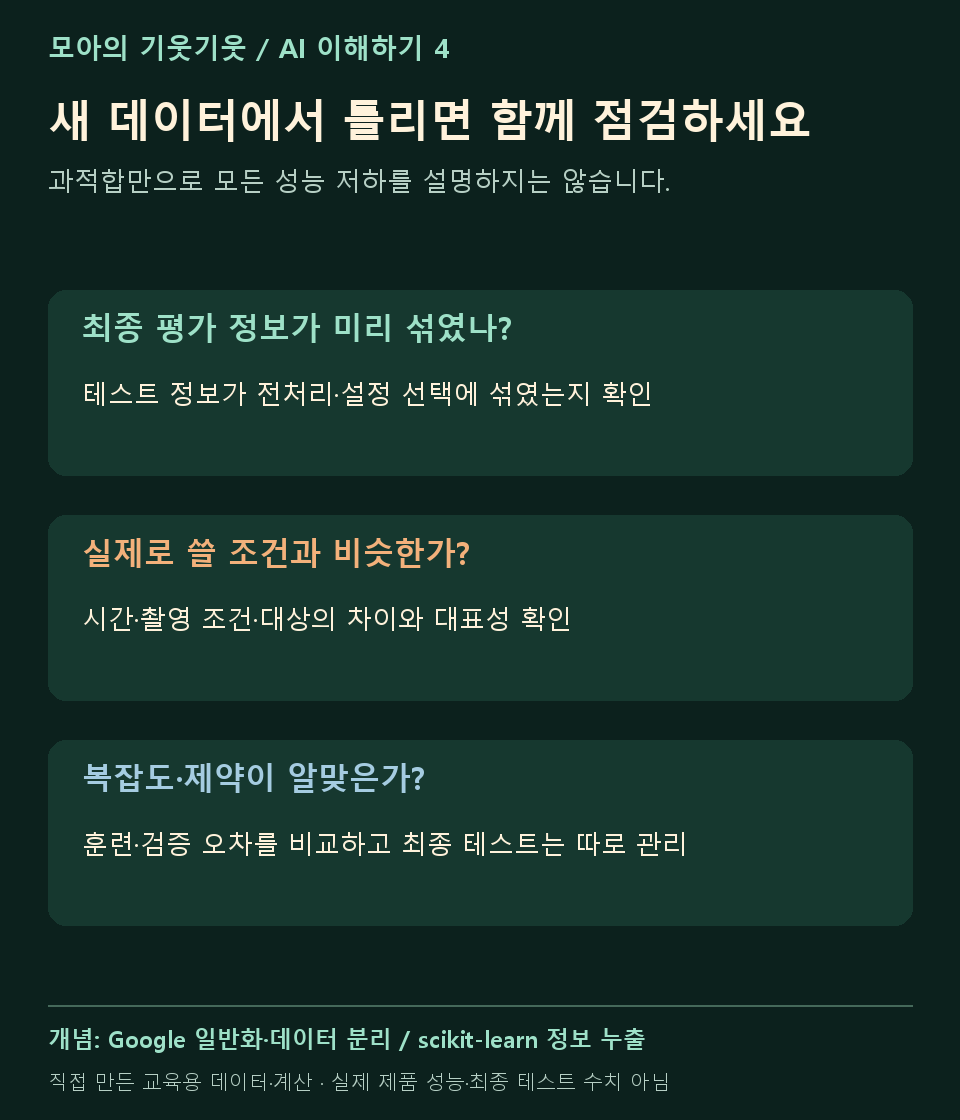
훈련 오차와 검증 오차는 유한 표본의 잡음 차이로 대소가 뒤바뀔 수도 있습니다. 검증 결과로 설정을 선택하고, 최종 테스트는 별도로 관리합니다.
그림으로 다시 보기
56초 영상으로 복습하기
56초 · 한국어 자막 애니메이션 · 음성 없음